← Tutti i progettiCase study · 01

Newmann

Un assistente email con AI che legge la posta come la leggeresti tu: scrive bozze di risposta con la tua voce e permette di automatizzare etichette e regole, costruendole a mano oppure descrivendole in chat.

Ruolo

Founding Engineer & Tech Lead

Tipo

Newmann AI

Anno

Dal 2024 a oggi

Categoria

Sviluppo Web · AI Engineering

Next.jsReactTypeScriptJava Spring BootOpenAIPineconeSupabasePostgreSQLGmail APIMicrosoft GraphOAuth2AzurePostHogResendGitHub ActionsVercel
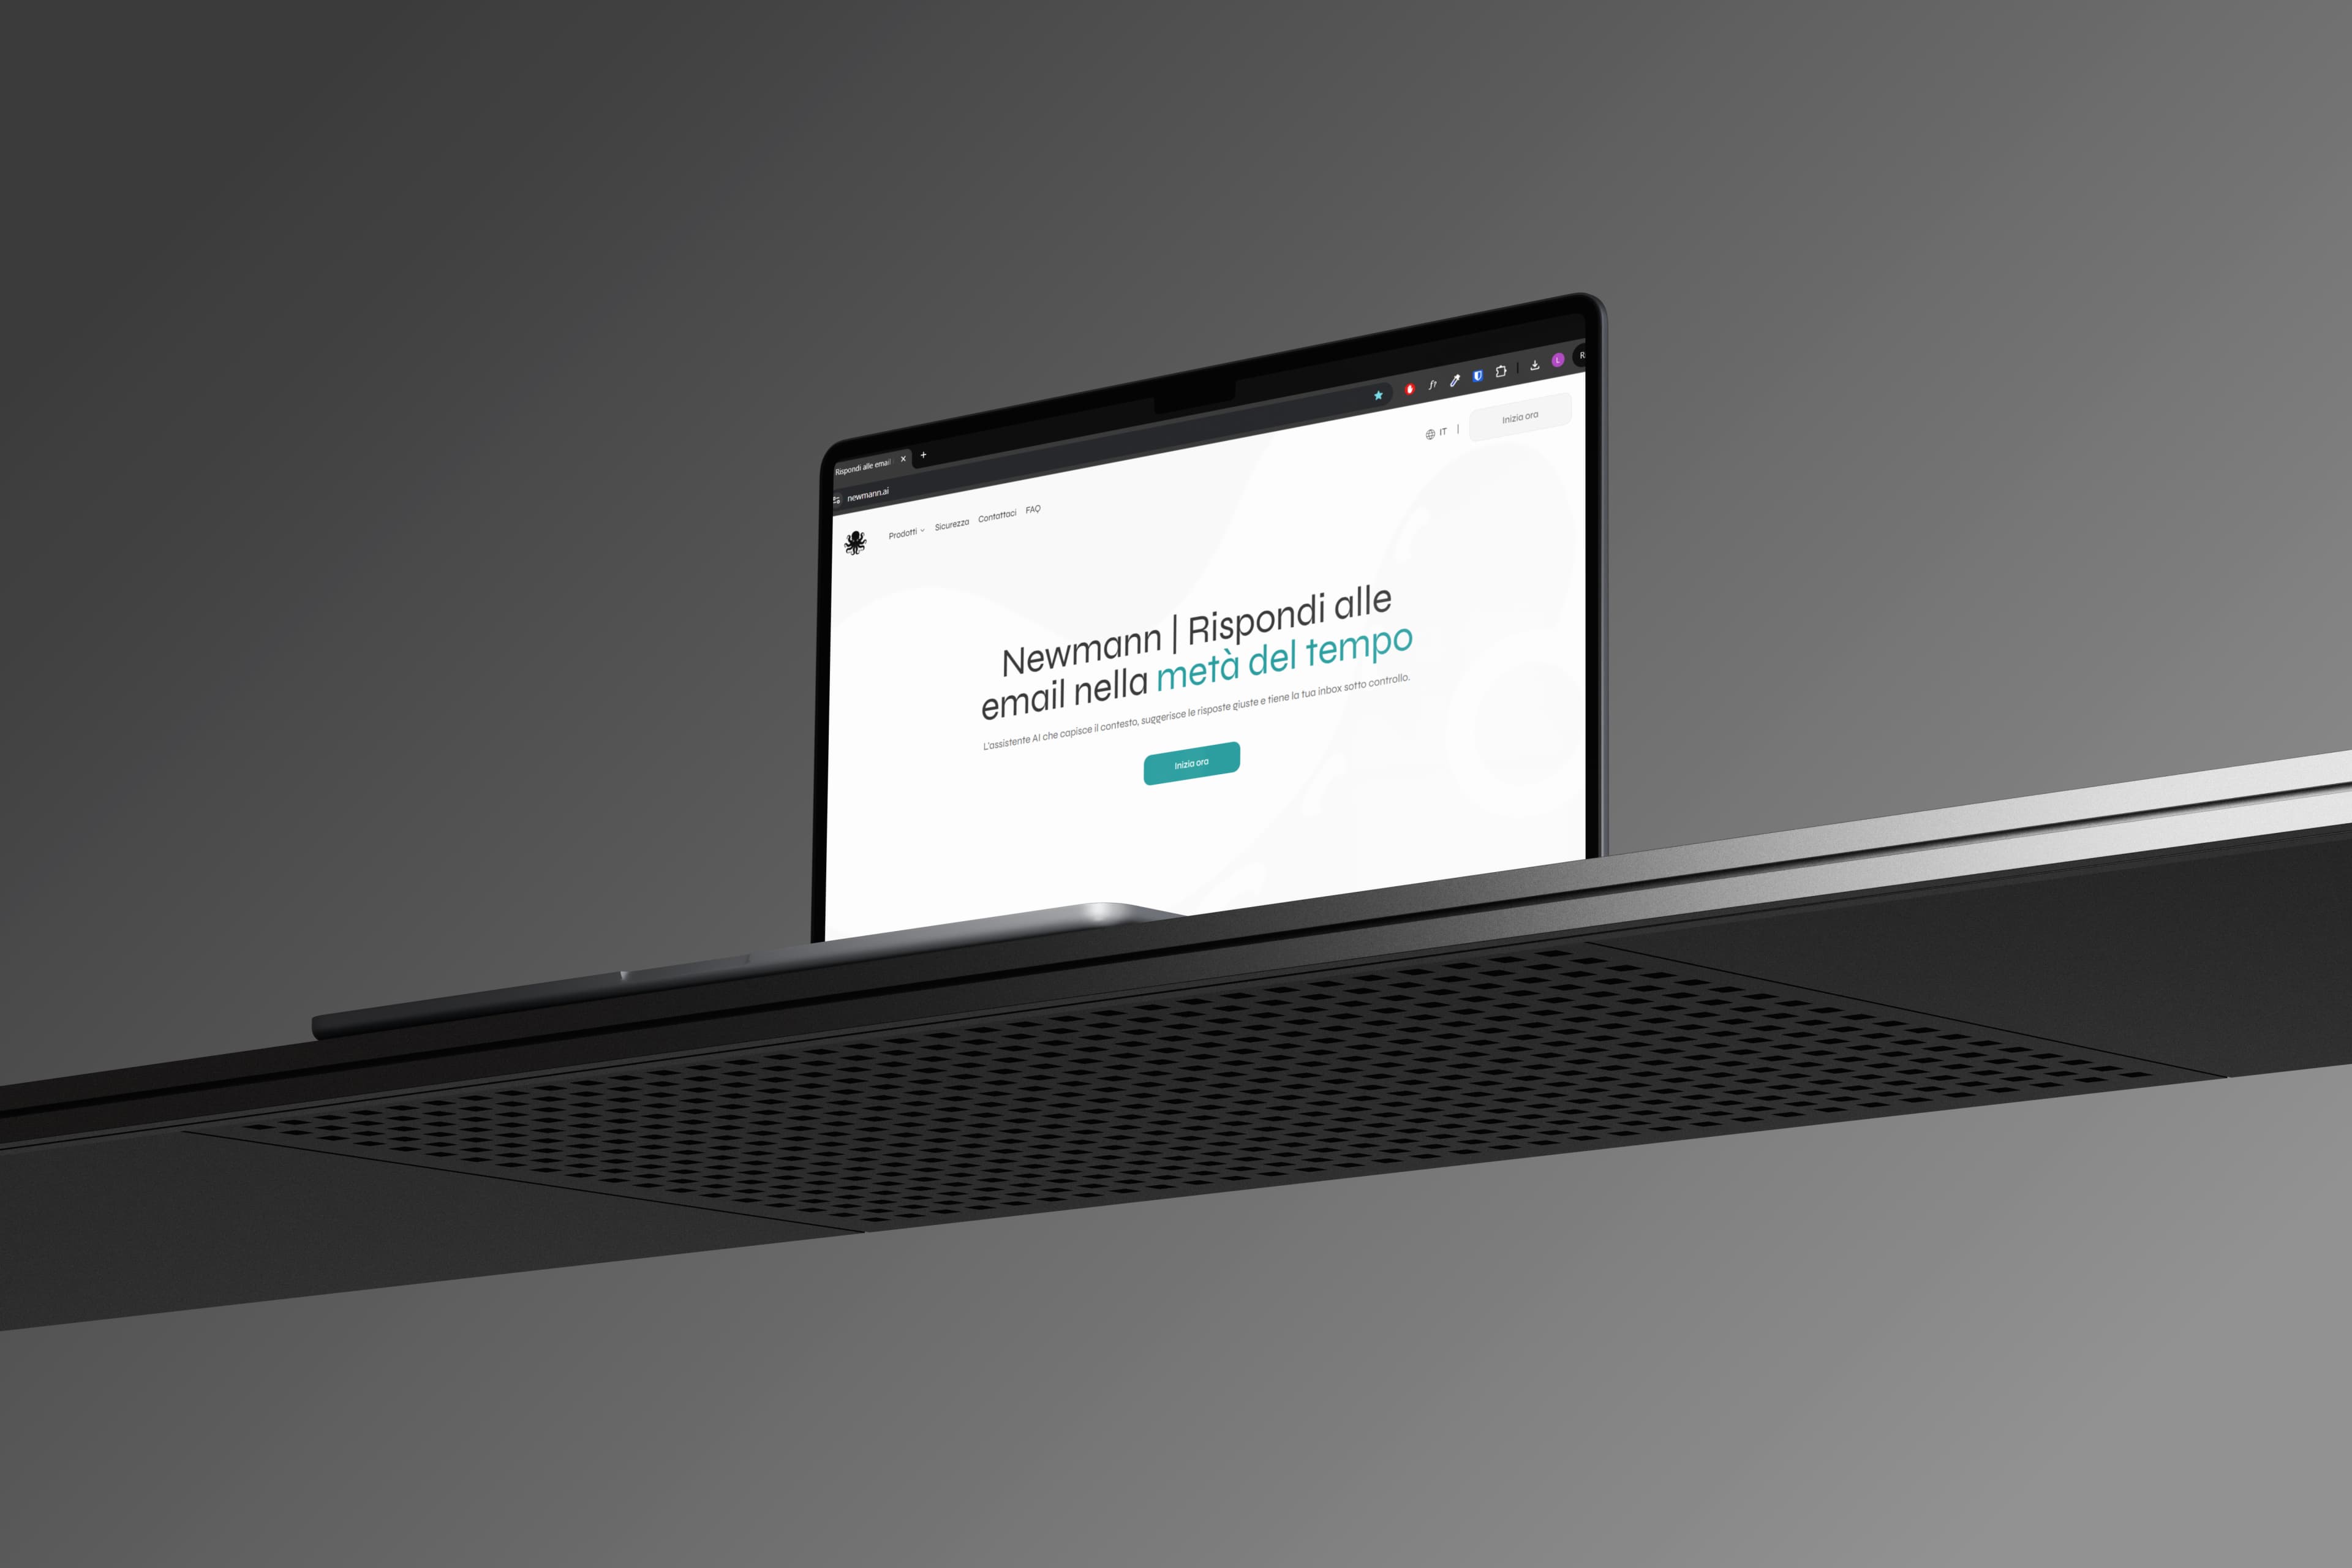
La dashboard della posta di Newmann mostrata su un mockup di laptop
Panoramica

Newmann è una piattaforma SaaS B2B che si collega a Gmail o Outlook e rende gestibile la casella di posta: decide che cosa merita davvero attenzione, scrive bozze di risposta fondate su come hai risposto a email simili in passato e applica le etichette e le regole che definisci, in un rule builder oppure descrivendole a un chatbot. La piattaforma è attualmente in fase di test, in vista del primo rilascio.

Il mio ruolo

Ho partecipato al progetto dal primo giorno come Founding Engineer e Tech Lead. Ho la responsabilità dell'architettura e delle scelte tecnologiche, dalla selezione dello stack al design della REST API in Java Spring Boot, e dell'AI engineering dall'inizio alla fine: ogni prompt è scritto da zero e la pipeline di retrieval su Pinecone è mia. Lavoro insieme a due persone, una sul front-end e una sul back-end, che portano avanti l'implementazione, e le decisioni che danno forma al sistema passano da me.

La sfida

Un modello generico sa scrivere un'email educata. Non sa scrivere la tua email. Il prodotto funziona solo se la bozza suona come la persona che la manda e se l'assistente capisce quando è meglio tacere: due condizioni da rispettare elaborando ogni messaggio che arriva in casella, a un costo per email che un abbonamento possa assorbire.

01

Le bozze dovevano fondarsi sullo storico di ogni utente, non sulla voce generica di un modello

02

Le notifiche push di Gmail possono arrivare più di una volta, quindi la pipeline doveva essere idempotente e non produrre mai bozze, etichette o vettori duplicati

03

Newsletter e mittenti automatici sono una fetta enorme di qualsiasi casella: far girare un LLM su tutti avrebbe bruciato budget per nulla

04

Due provider, Gmail e Microsoft, ognuno con il proprio flusso OAuth e la propria idea di che cosa sia un'etichetta

05

Gli utenti avevano bisogno sia di un controllo preciso sulle automazioni sia di un modo per crearle senza imparare una sintassi di regole

Processo

Come è nato

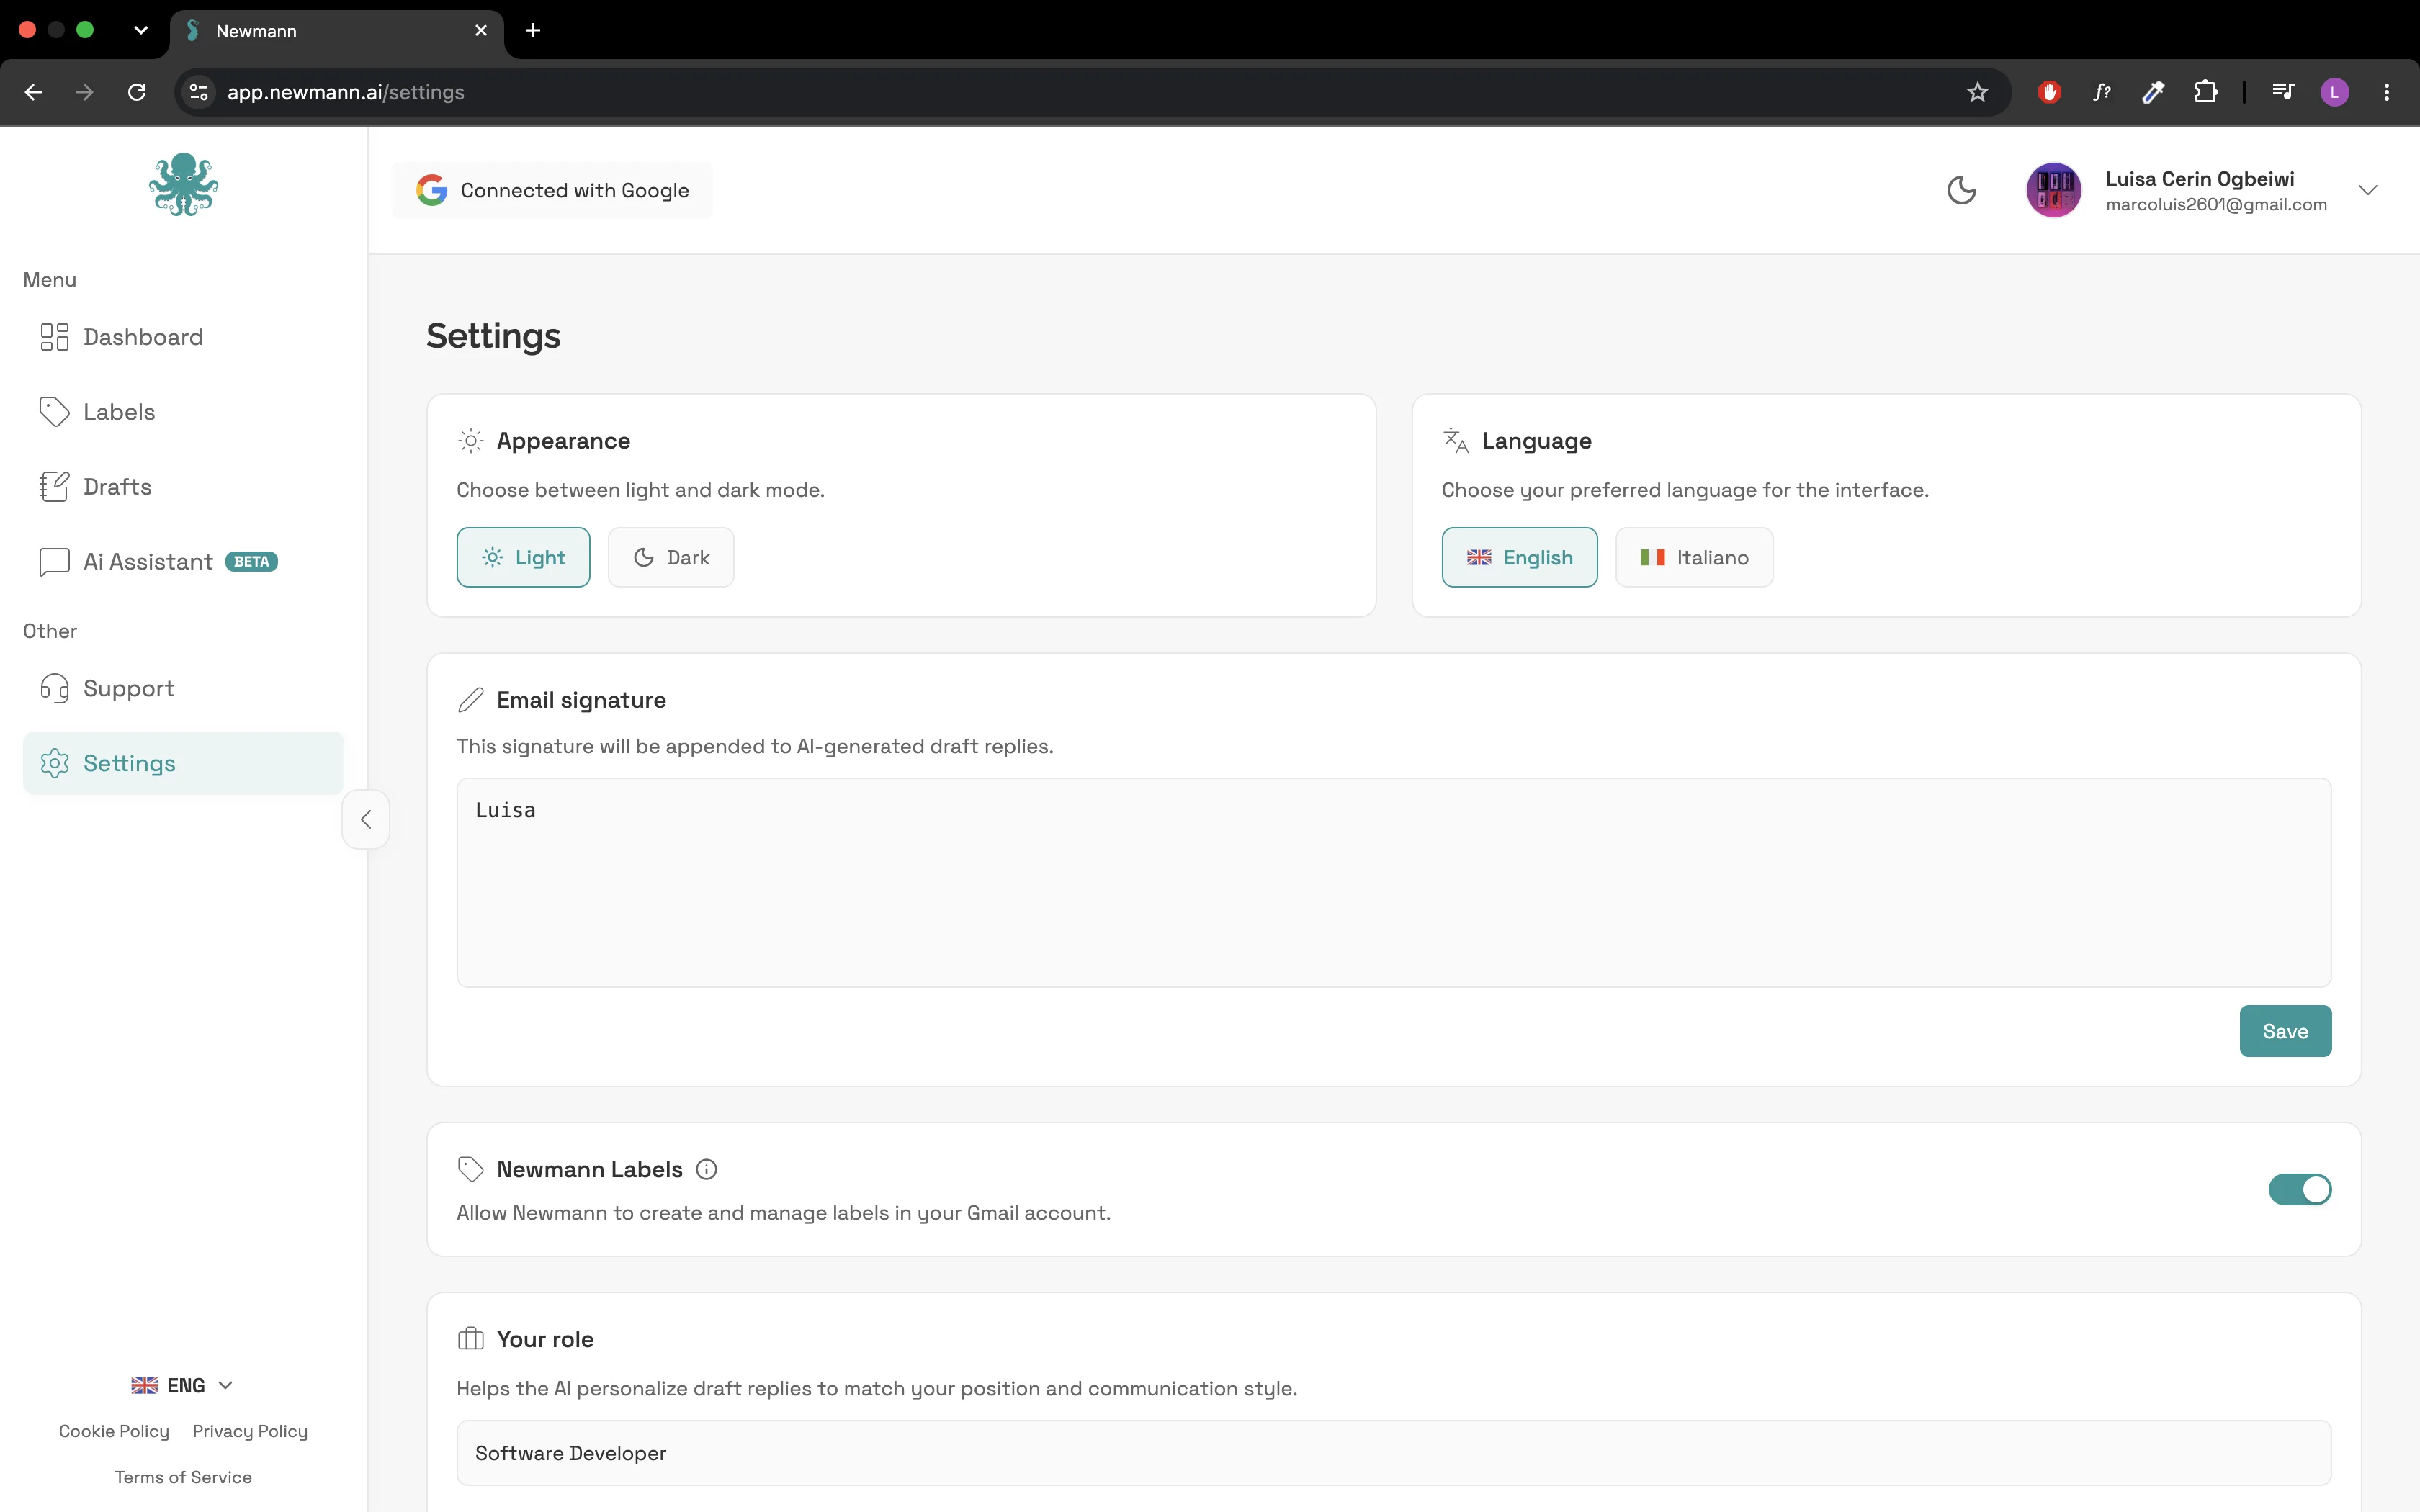
Le impostazioni di Newmann: tema, lingua, firma email, etichette Newmann e ruolo dell'utente
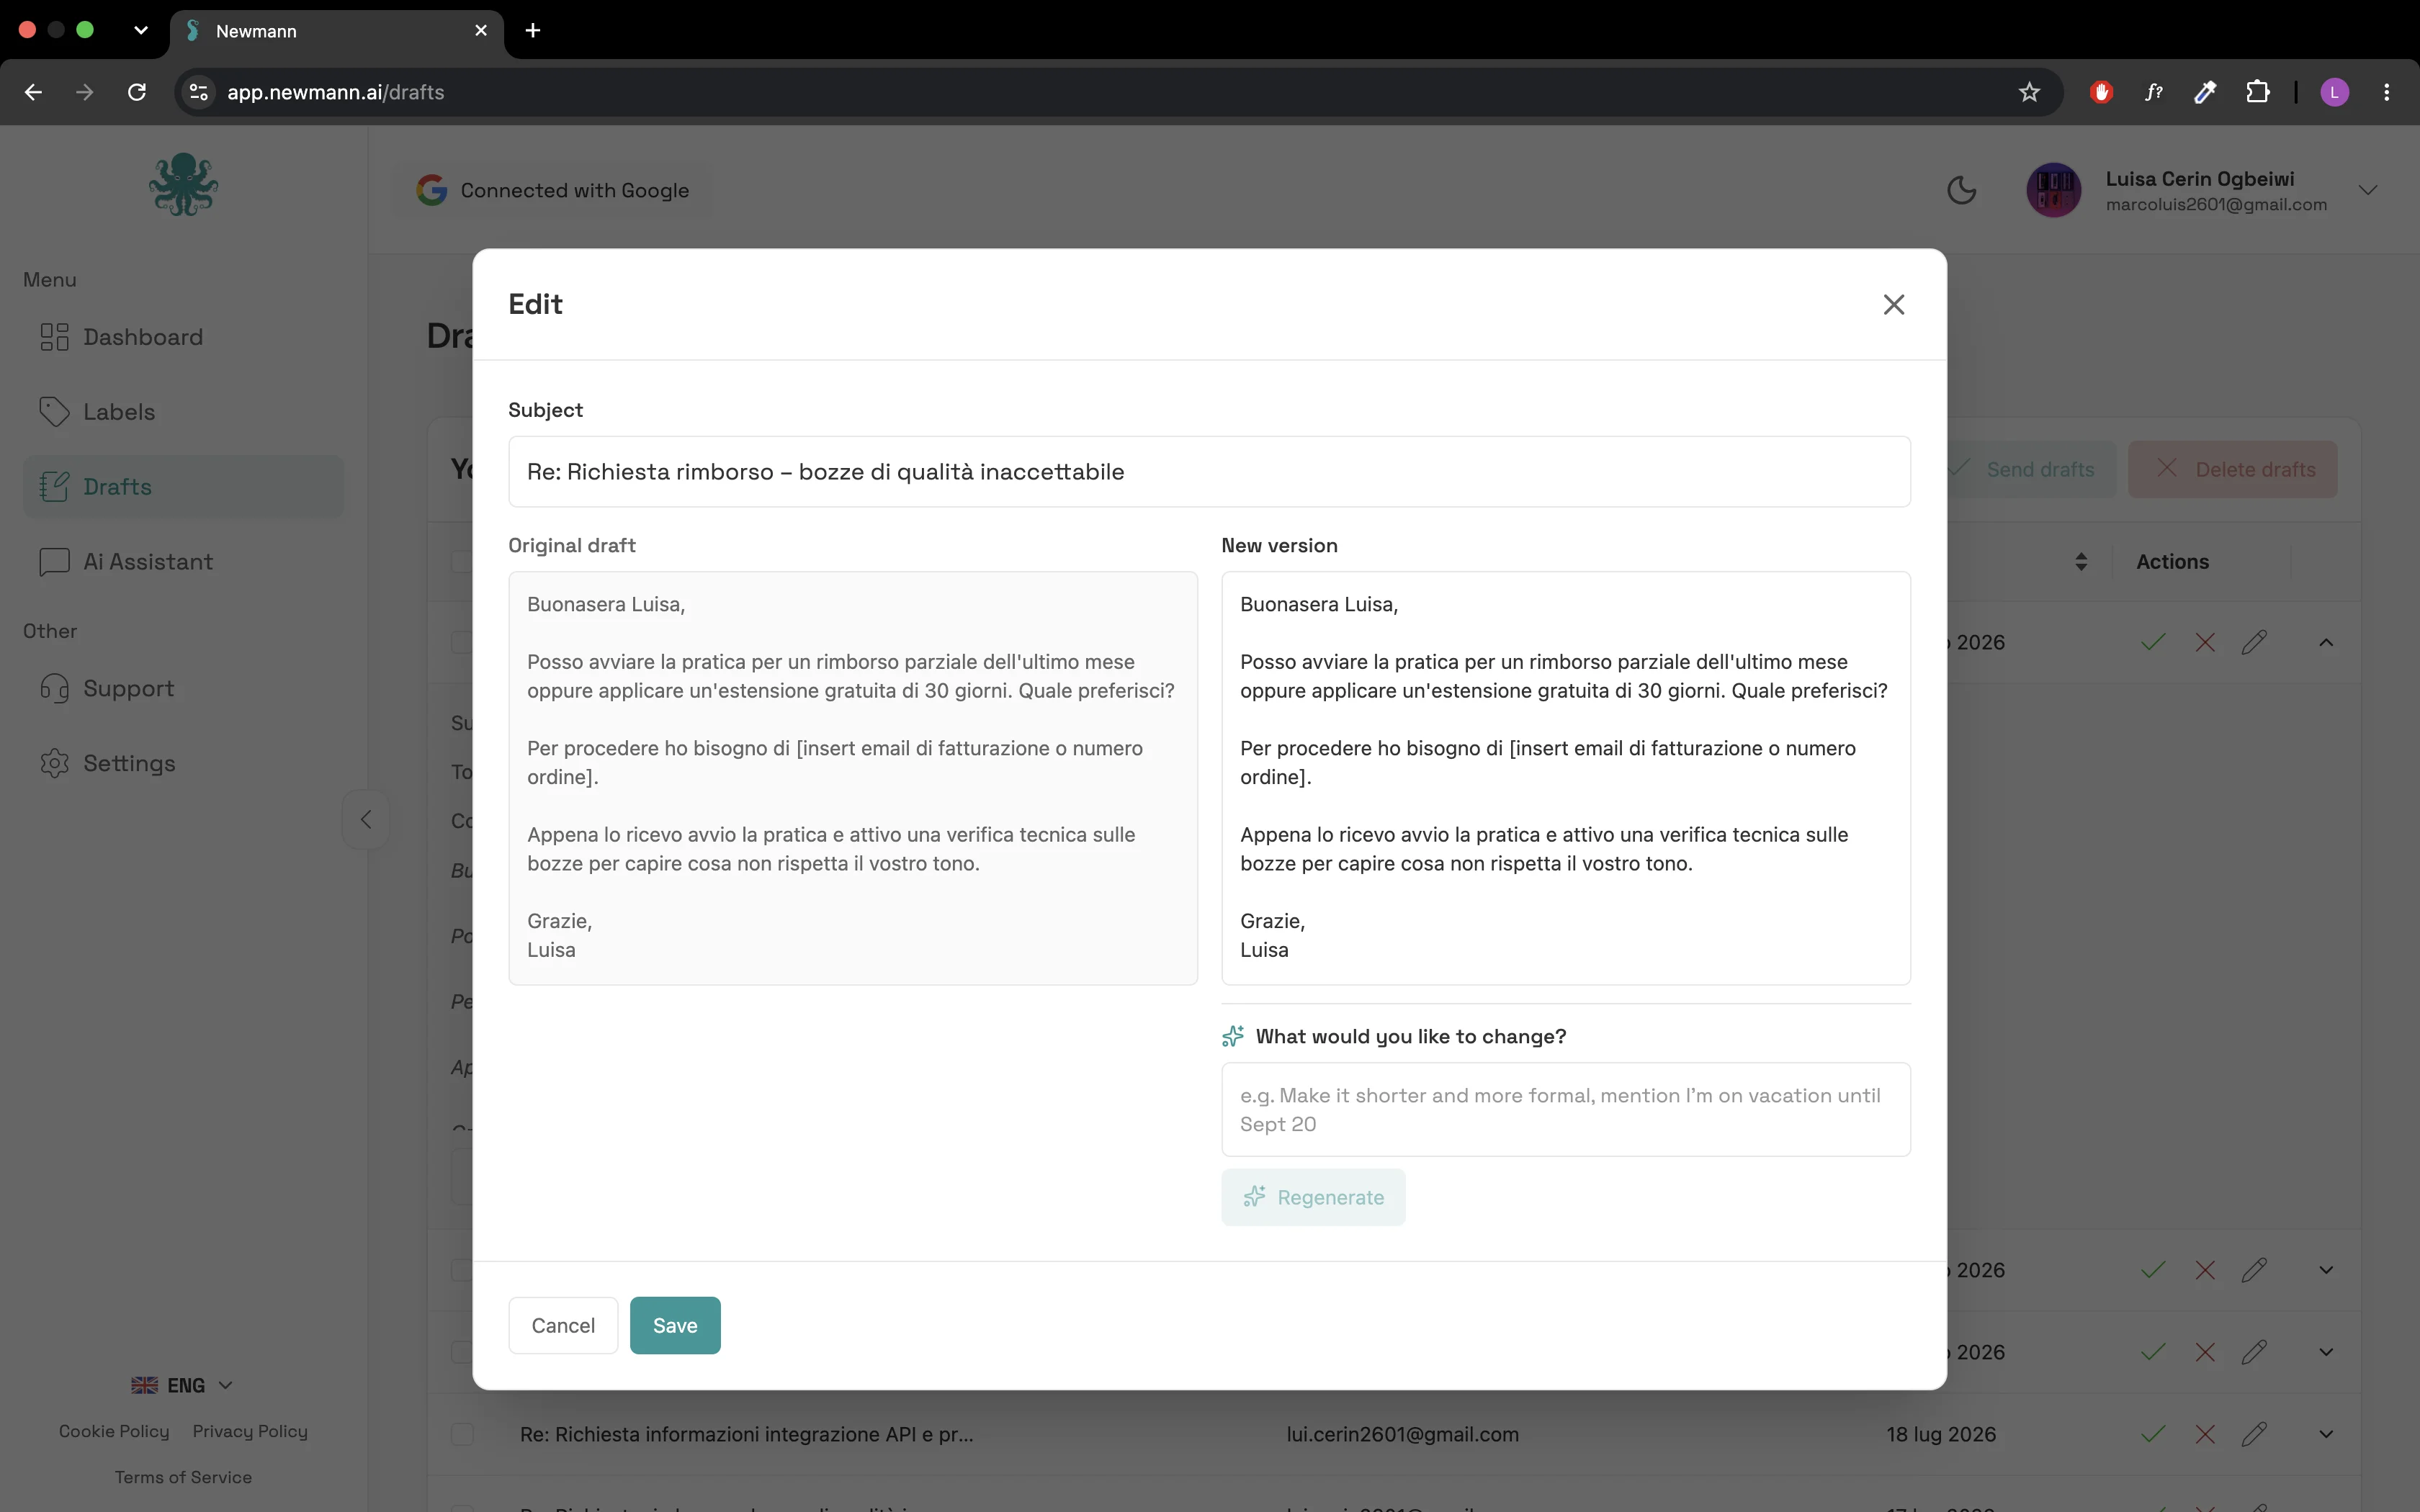
La modifica di una bozza in Newmann: la bozza originale accanto alla nuova versione, con il campo per chiedere all'AI di rigenerarla
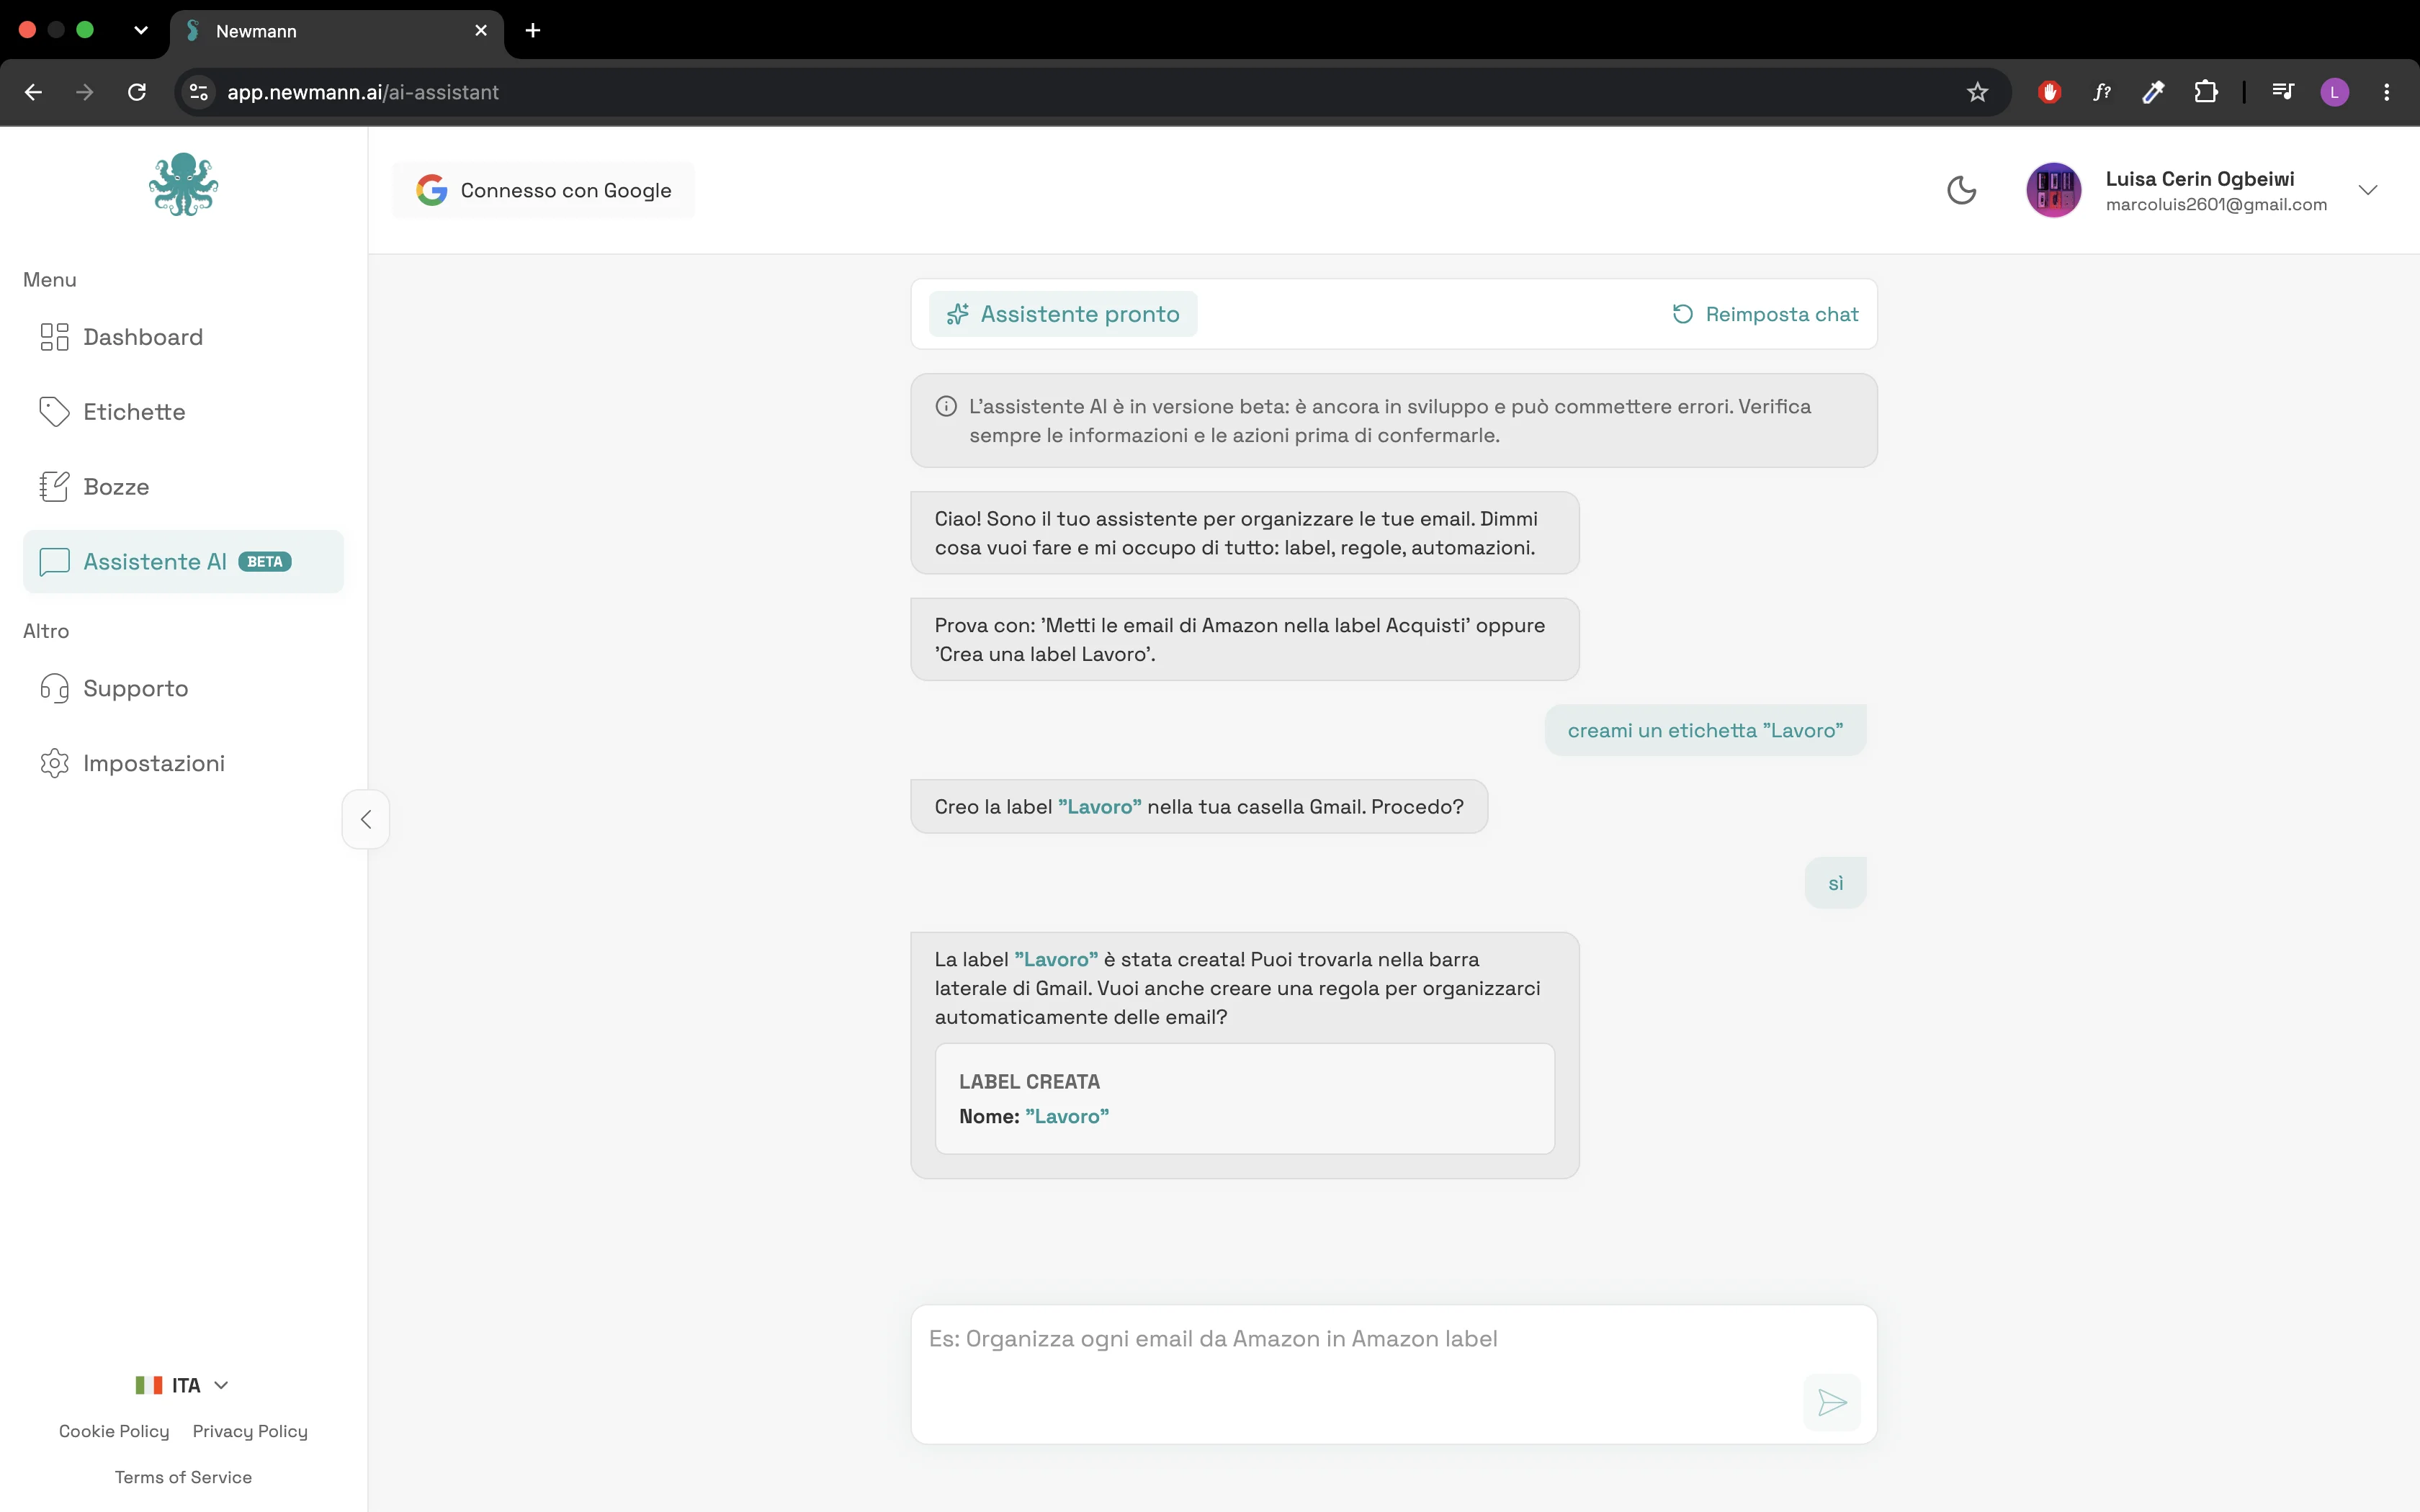
La chat di automazione di Newmann che crea un'etichetta a partire da una descrizione in linguaggio naturale
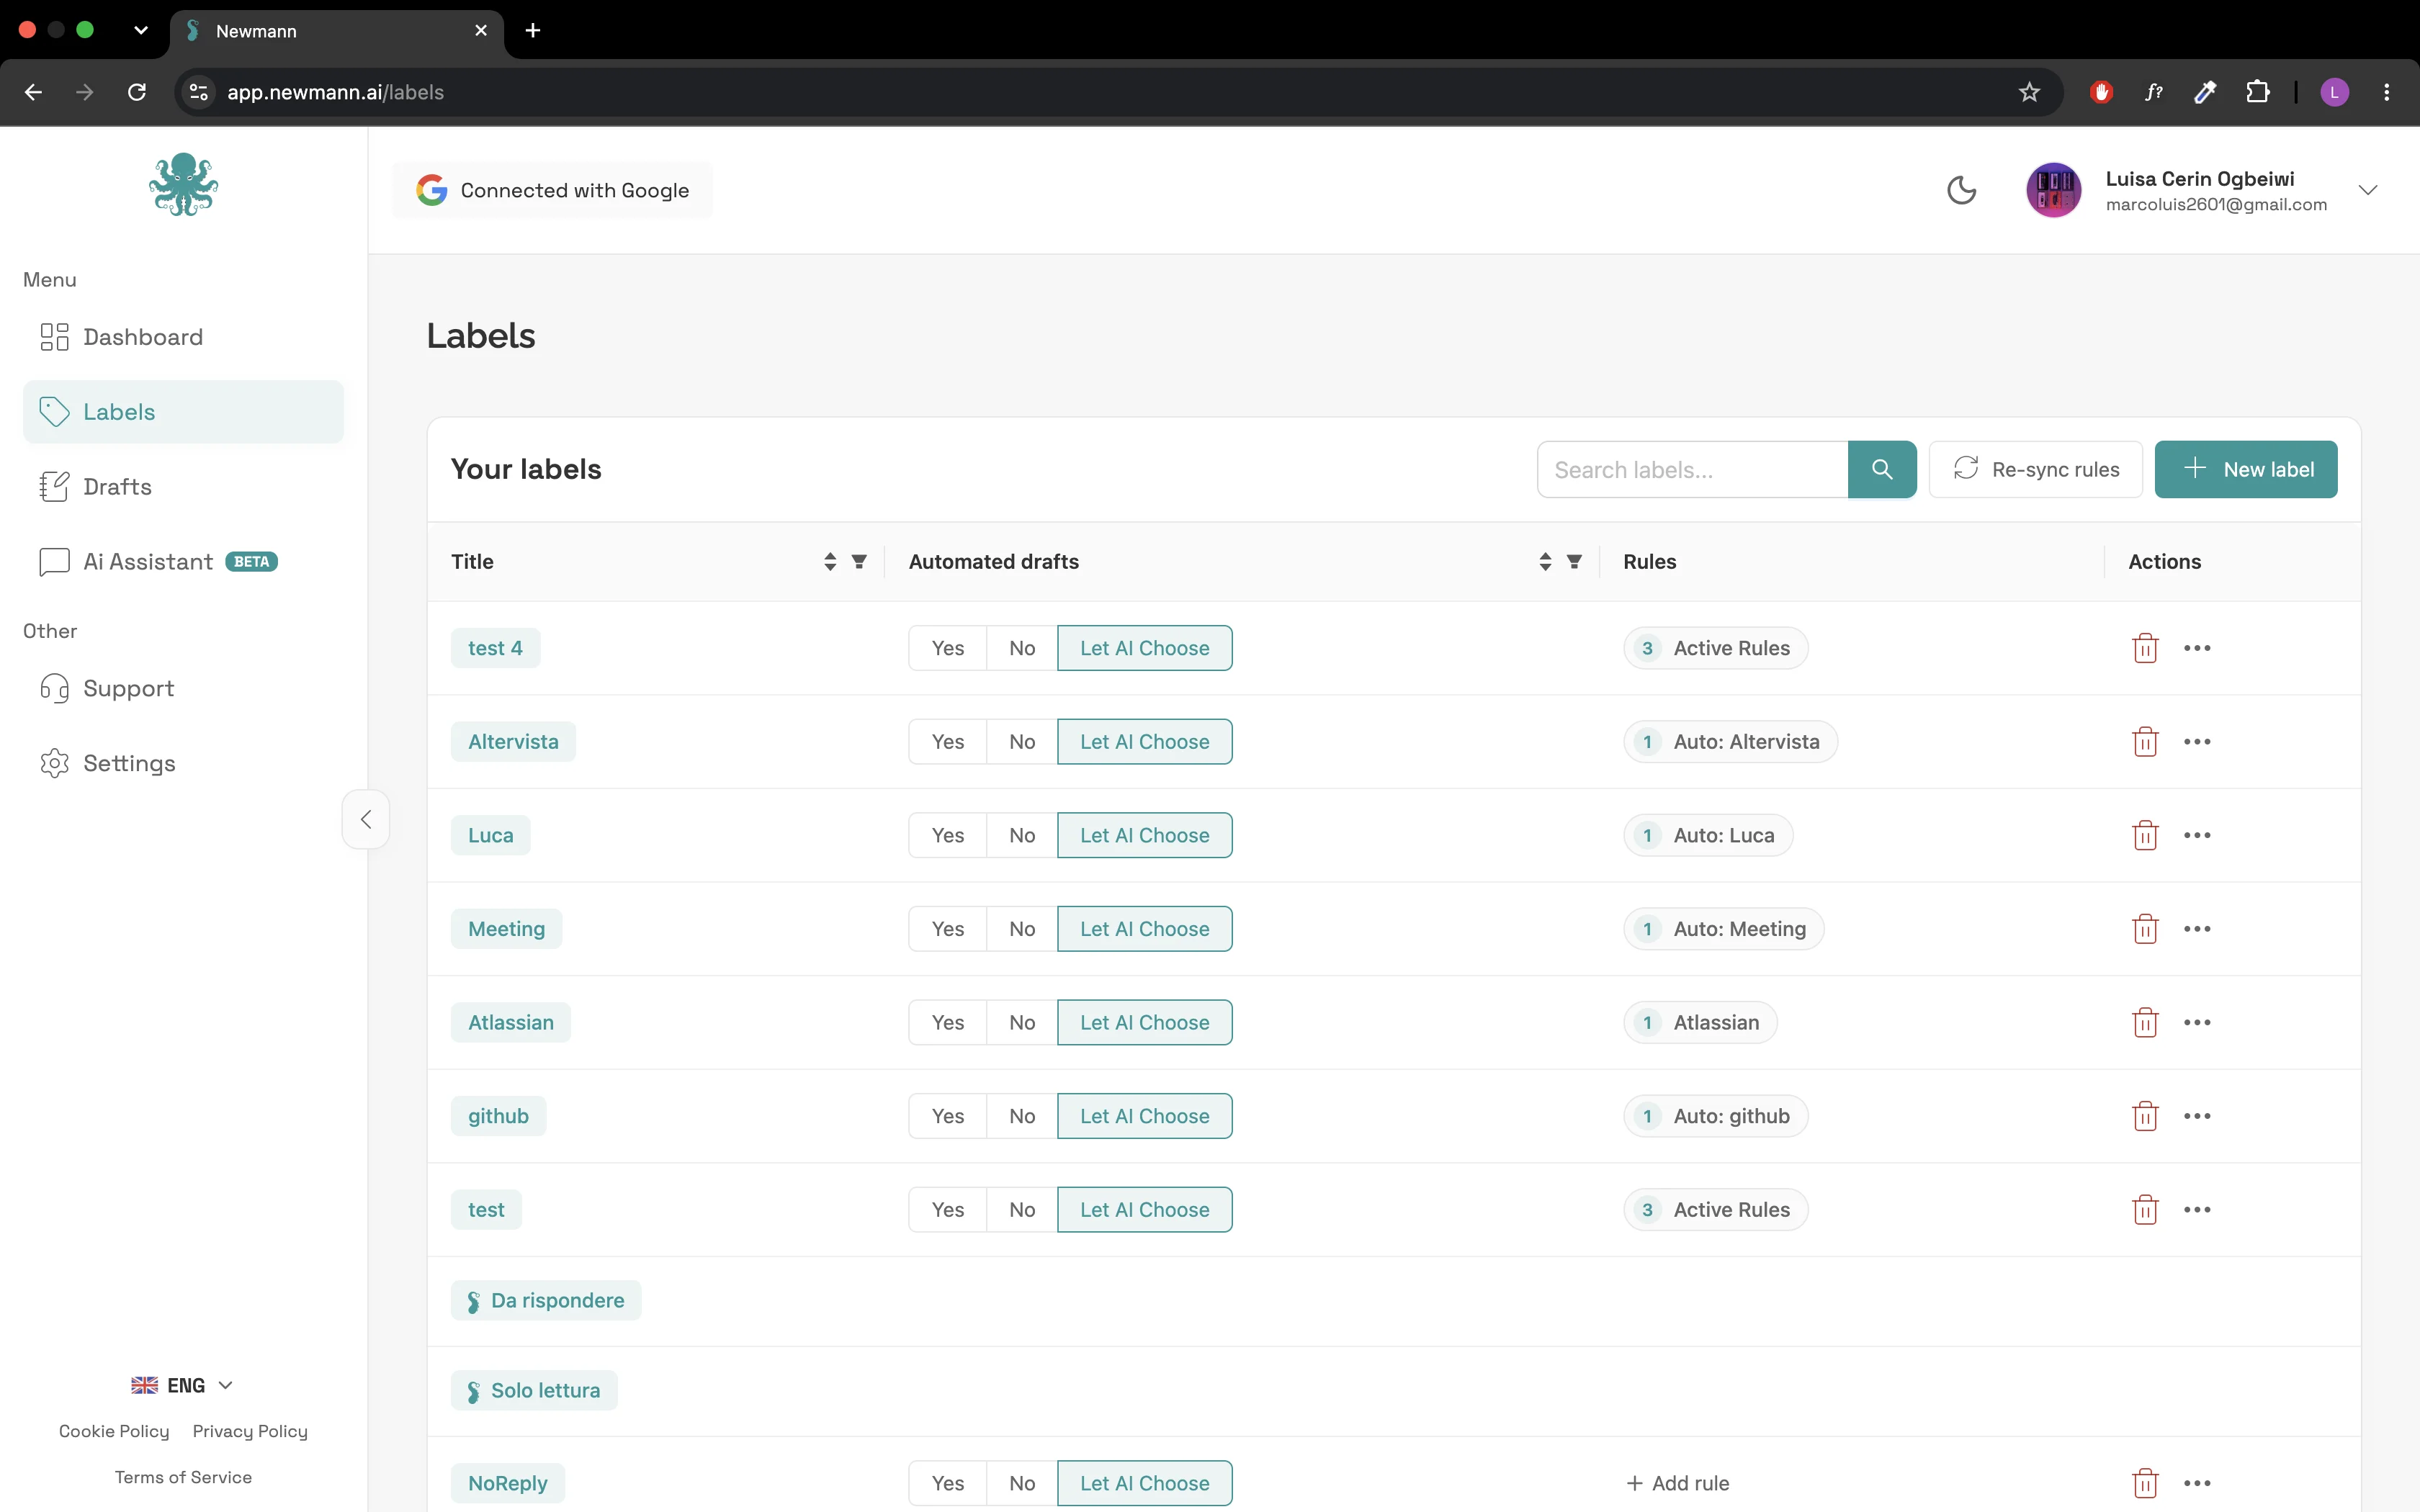
L'elenco delle etichette in Newmann, con la scelta sulle bozze automatiche e le regole collegate a ogni etichetta
01

L'architettura e la pipeline di ingestione

Spring Boot espone la REST API, PostgreSQL su Supabase conserva i dati con row-level security e contenuti multilingua, e Next.js con React e TypeScript regge il front-end. La posta in arrivo passa da una pipeline a webhook costruita intorno a chiavi di idempotenza e deduplicazione, così lo stesso messaggio può essere consegnato due volte senza mai generare una seconda bozza. I provider sono modellati per singolo account email invece che per tipo di provider: è questo che ha reso l'aggiunta di Microsoft accanto a Gmail una modifica di configurazione anziché una riscrittura.

02

Retrieval, prompt e la voce dell'utente

Ogni email rilevante viene trasformata in embedding e salvata su Pinecone, così a un nuovo messaggio si risponde avendo in contesto gli scambi passati dell'utente. Tengo namespace separati per le email di contesto e per i segnali di feedback: quando condividevano lo stesso namespace, le bozze rifiutate inquinavano il retrieval e spingevano il modello proprio verso le risposte che l'utente aveva scartato. Anche i rifiuti sono categorizzati, perché «qui non serviva rispondere» e «il tono era sbagliato» sono due lezioni diverse e solo una delle due deve fermare le bozze future.

03

Due modi per costruire un'automazione

Il rule builder dà controllo totale: definisci l'etichetta, le condizioni e la descrizione testuale su cui lavora il modello, e vedi esattamente che cosa succederà. Accanto c'è un chatbot per tutto il resto: descrivi quello che vuoi e un flusso multi-turno con stato assembla la stessa regola, chiedendo i pezzi mancanti e fermandosi a chiedere conferma quando somiglia a una che esiste già. Entrambe le strade scrivono su un unico modello di regola, quindi niente si comporta in modo diverso a seconda di dove è stato creato.

04

Metterlo in produzione e tenerlo osservabile

La CI gira su GitHub Actions per front-end e back-end, con branch protection; il front-end viene deployato su Vercel e la API Spring Boot gira su Azure, con migrazioni Flyway su Supabase. Ho impostato l'analytics di prodotto su PostHog EU e le email transazionali su Resend; la pipeline di deploy è stata costruita insieme a un'altra persona del team e la manteniamo insieme. Stabilizzare l'ambiente di deploy ha voluto dire lavorare su redirect OAuth, CORS, dimensionamento del pool HikariCP e routing delle connessioni Supabase attraverso il session pooler: la metà poco affascinante del gestire un'infrastruttura propria.

Decisioni chiave

Le scelte che hanno definito il prodotto

Riconoscere i mittenti automatici dagli header, l'AI solo come fallback

Perché

Newsletter e mittenti no-reply si dichiarano negli header dell'email. Leggerli non costa nulla e copre circa il 95% dei casi, così il modello viene chiamato solo per quelli davvero ambigui. Quelle email finiscono comunque su Pinecone come contesto: si salta soltanto la generazione della bozza.

Compromesso

Un'euristica scritta a mano da mantenere via via che i mittenti cambiano il modo di identificarsi.

Namespace Pinecone separati per scopo di retrieval

Perché

Contesto e feedback rispondono a domande diverse. Tenerli distinti è la differenza tra una bozza informata da come scrivi e una bozza che deriva verso ciò che hai già rifiutato.

Compromesso

Più namespace da gestire, e ogni nuovo tipo di segnale richiede una decisione esplicita su dove collocarlo.

Un rule builder e un chatbot, non l'uno o l'altro

Perché

Chi sa esattamente che cosa vuole non dovrebbe dover trattare con una chat, e chi non lo sa non dovrebbe dover imparare un form. Entrambe le superfici producono la stessa regola, quindi la scelta riguarda la comodità, non le funzionalità.

Compromesso

Due interfacce su un solo modello: ogni cambiamento a ciò che una regola può fare deve arrivare in entrambe, e le conversazioni multi-turno con stato sono molto più difficili da testare di un form.

Parallelizzazione e caching invece di un framework AI più pesante

Perché

Il tempo di risposta che gli utenti percepiscono dipende da quante chiamate al modello girano in parallelo e da quante vengono evitate del tutto. Parallelizzazione con CompletableFuture, batching e una cache lazy per la valutazione dell'importanza hanno spostato i numeri; un ulteriore livello di astrazione no.

Compromesso

Più concorrenza da governare, e il caching impone di essere espliciti su quando un verdetto obsoleto è accettabile.

Analytics e infrastruttura ospitate in UE fin dall'inizio

Perché

Nel sistema passano contenuti di email e i clienti sono europei. Scegliere servizi ospitati in UE quando la codebase era ancora piccola ha reso la data residency un'impostazione invece che una migrazione.

Compromesso

Una scelta di provider più ristretta, a volte a un prezzo più alto.

Risultati

Che cosa è cambiato

~95%

dei mittenti automatici identificati in fase di test dai soli header dell'email, a costo zero di token

Gmail · Outlook

Entrambi i provider supportati con un modello per singolo account, ognuno con il proprio flusso OAuth2

Idempotente

Una pipeline a webhook con chiavi tali che consegne ripetute non possono produrre una seconda bozza, etichetta o vettore

2 strade

Un rule builder e un assistente conversazionale che scrivono su un unico modello di automazione

Galleria
La pagina di accesso di Newmann, con login tramite Google o Microsoft
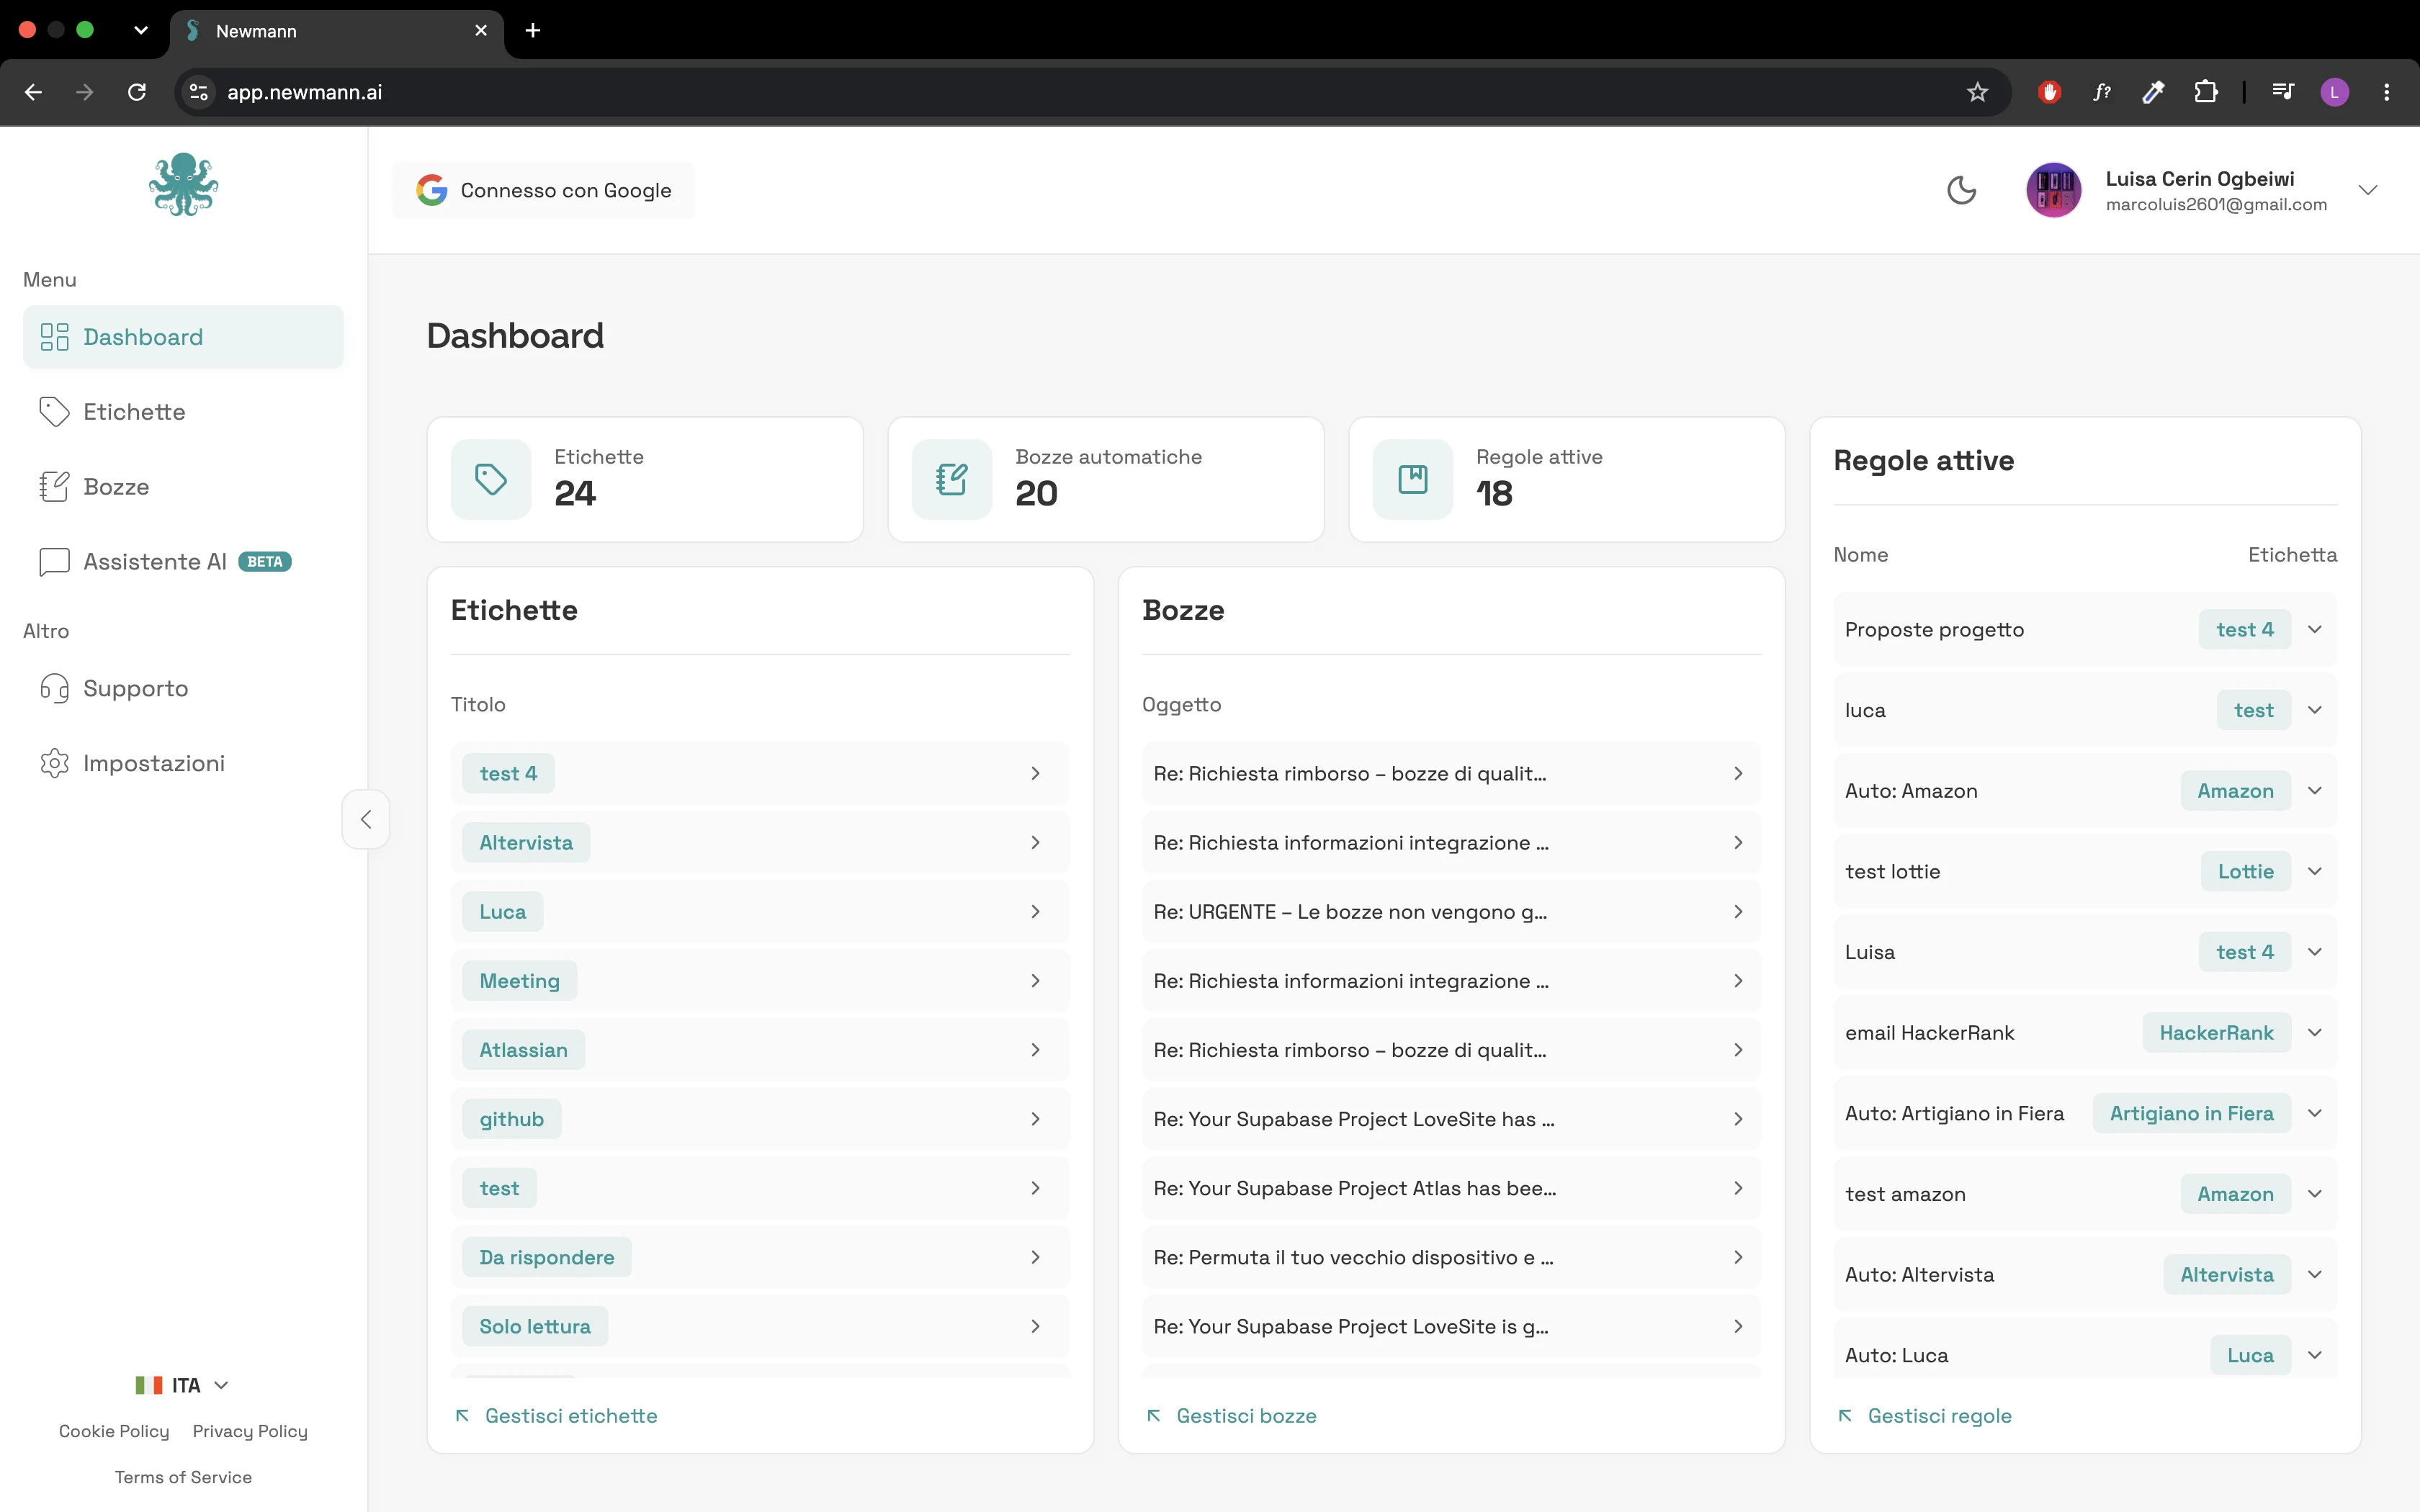
La dashboard di Newmann con etichette, bozze automatiche e regole attive
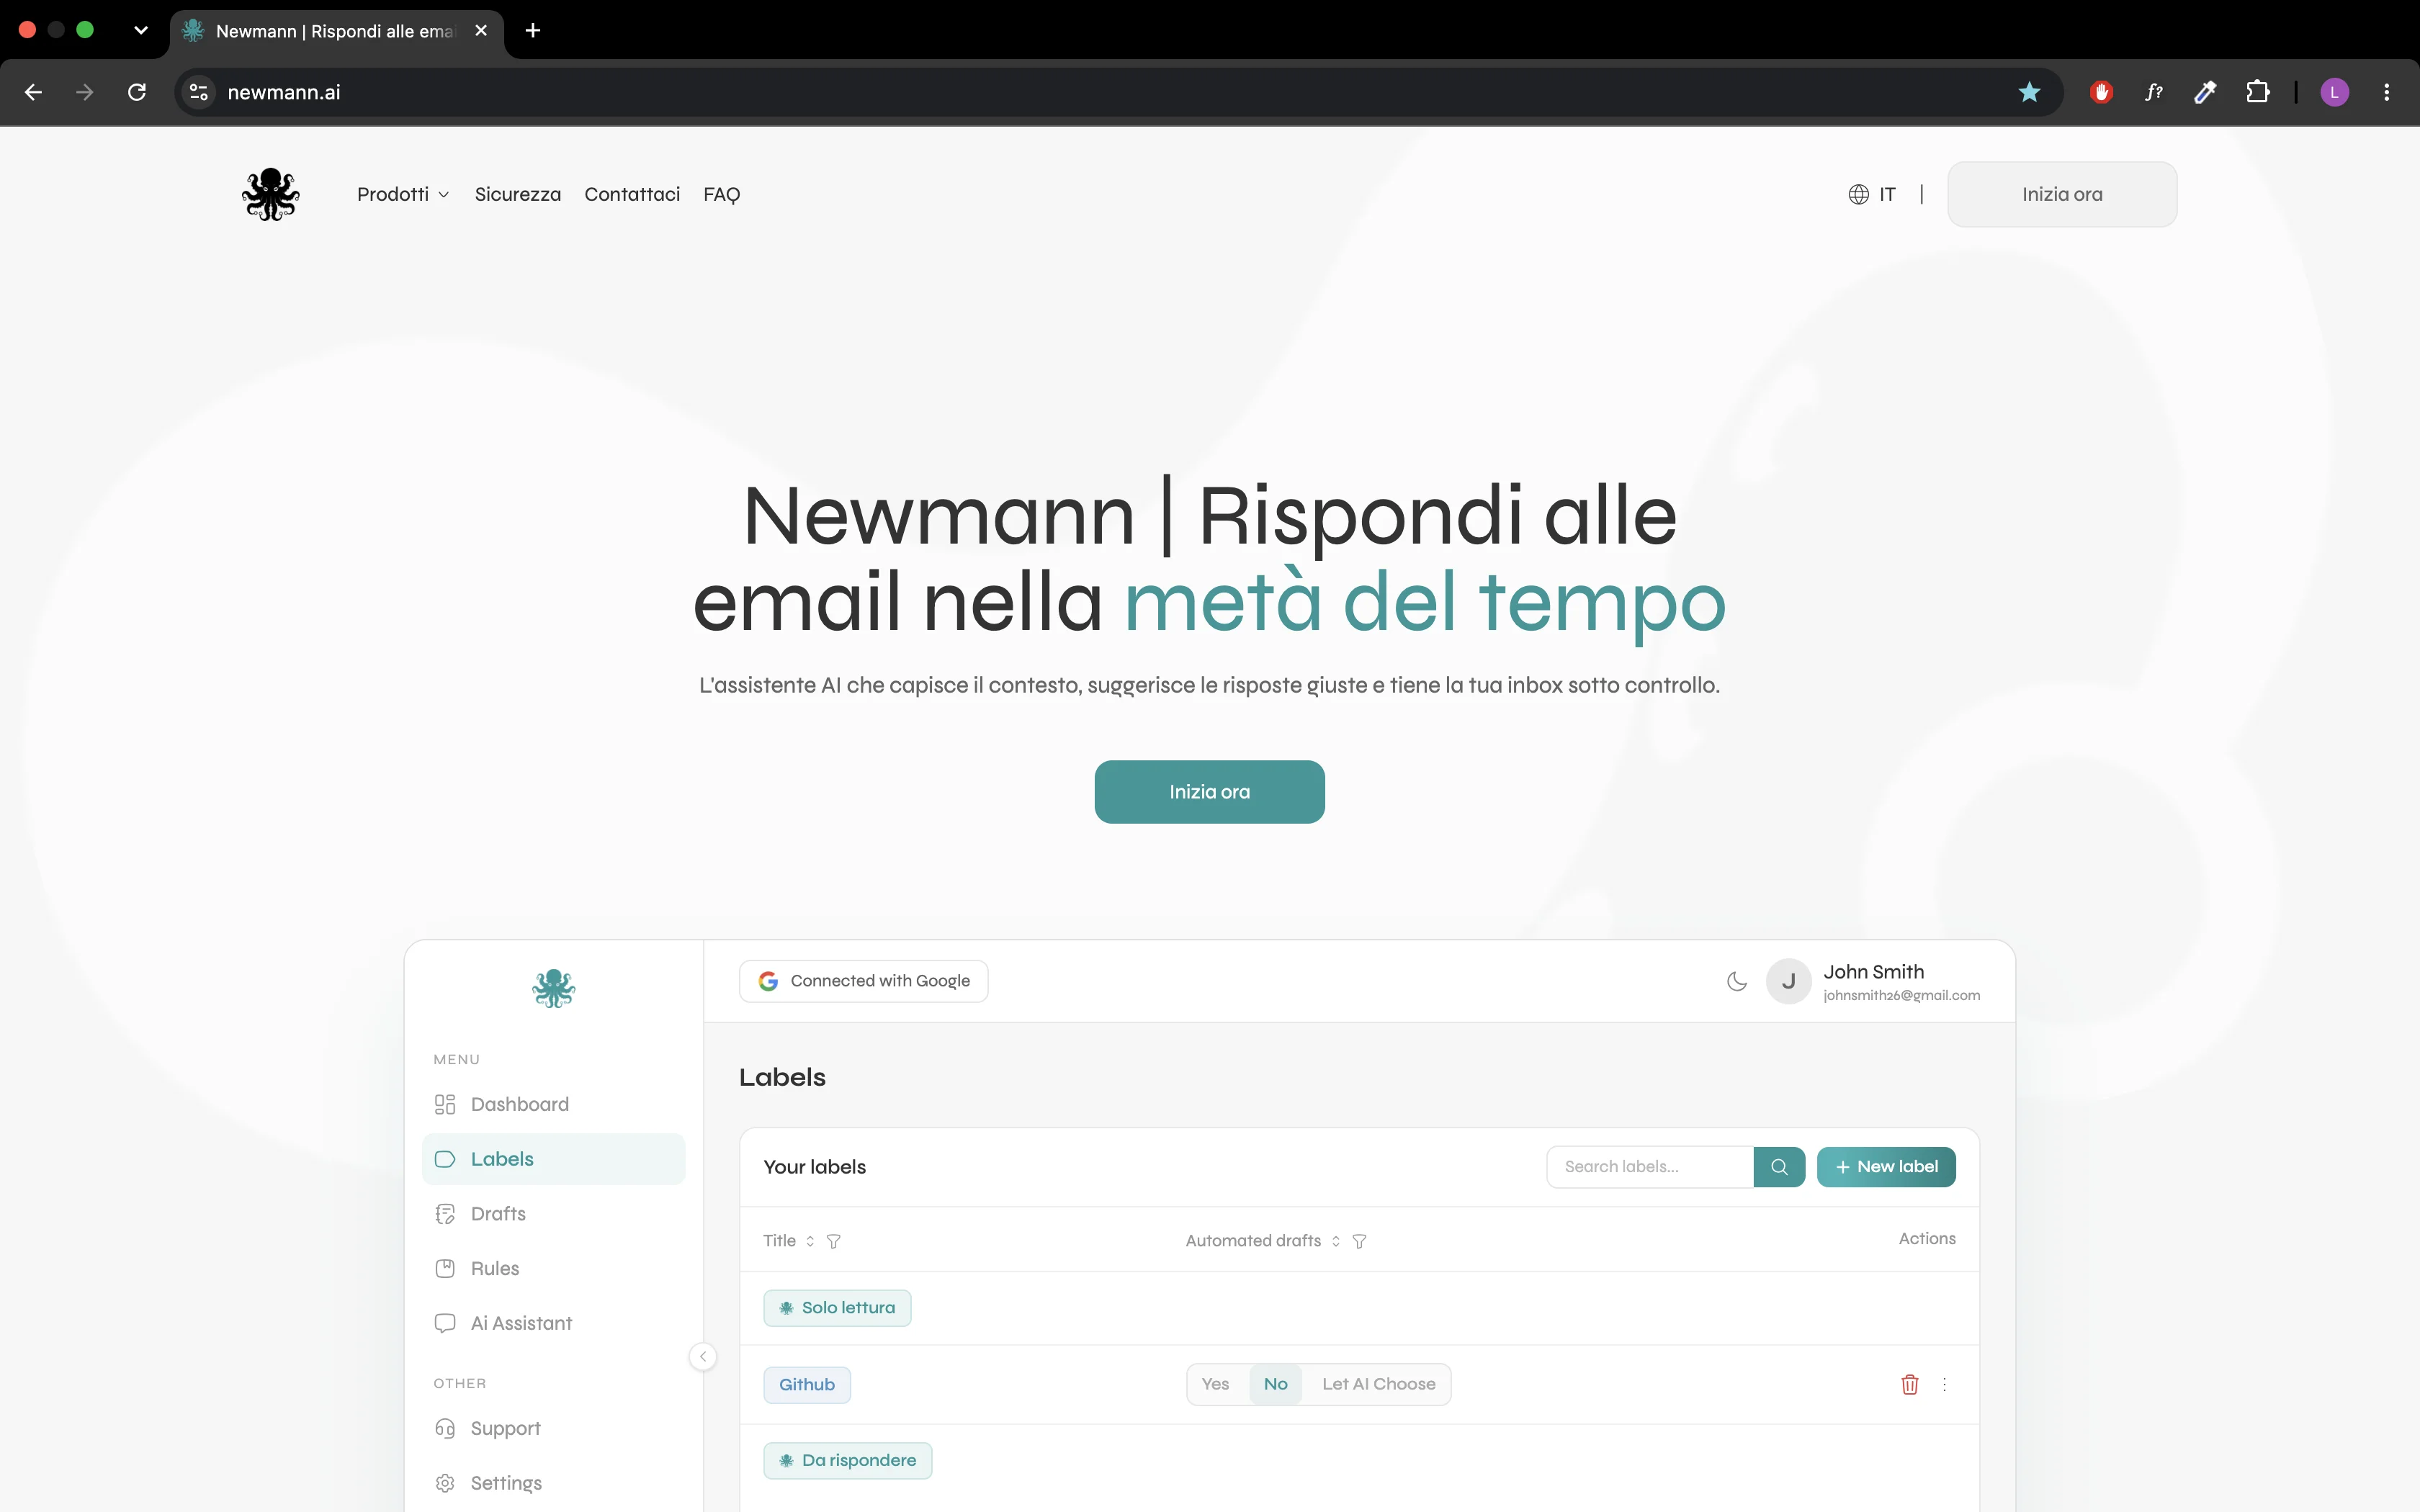
La landing page di Newmann
Che cosa ho imparato

Decidere prima l'architettura significa che ogni scorciatoia diventa l'eredità di qualcun altro. Isolare i provider per account, tenere separati i namespace di retrieval e rendere idempotente la pipeline sembravano tutte scelte sovradimensionate il primo giorno, e sono il motivo per cui altre due persone hanno potuto costruirci sopra senza rinegoziare le fondamenta.

La chiamata AI più economica è quella che non fai. Leggere un header prima di ricorrere a un modello ha cambiato l'economia unitaria del prodotto più di qualsiasi ottimizzazione dei prompt.

Il feedback non è un segnale solo. Trattare «non serviva rispondere» e «tono sbagliato» come lo stesso rifiuto ha insegnato in silenzio al sistema a smettere di essere utile, e separarli è stato un problema di modellazione molto prima che di prompting.

Offrire due strade verso la stessa funzionalità è valso la superficie duplicata, ma solo perché entrambe scrivono su un unico modello di regola. Se avessi lasciato che il chatbot costruisse la sua versione abbreviata, le due sarebbero divergute nel giro di un mese.

Progetto successivoAtlas→Tutti i progetti